Kioku
一个只服务一个人的个人记忆 API。PostgreSQL 里存着我的文章、工作经历、照片、邮件、财务和健康数据;这个网站只能读到其中公开的那一层视图,其余部分由我自己的 AI 客户端通过另一套工具接口访问 —— 它有自己的凭证,也有自己的数据库角色。
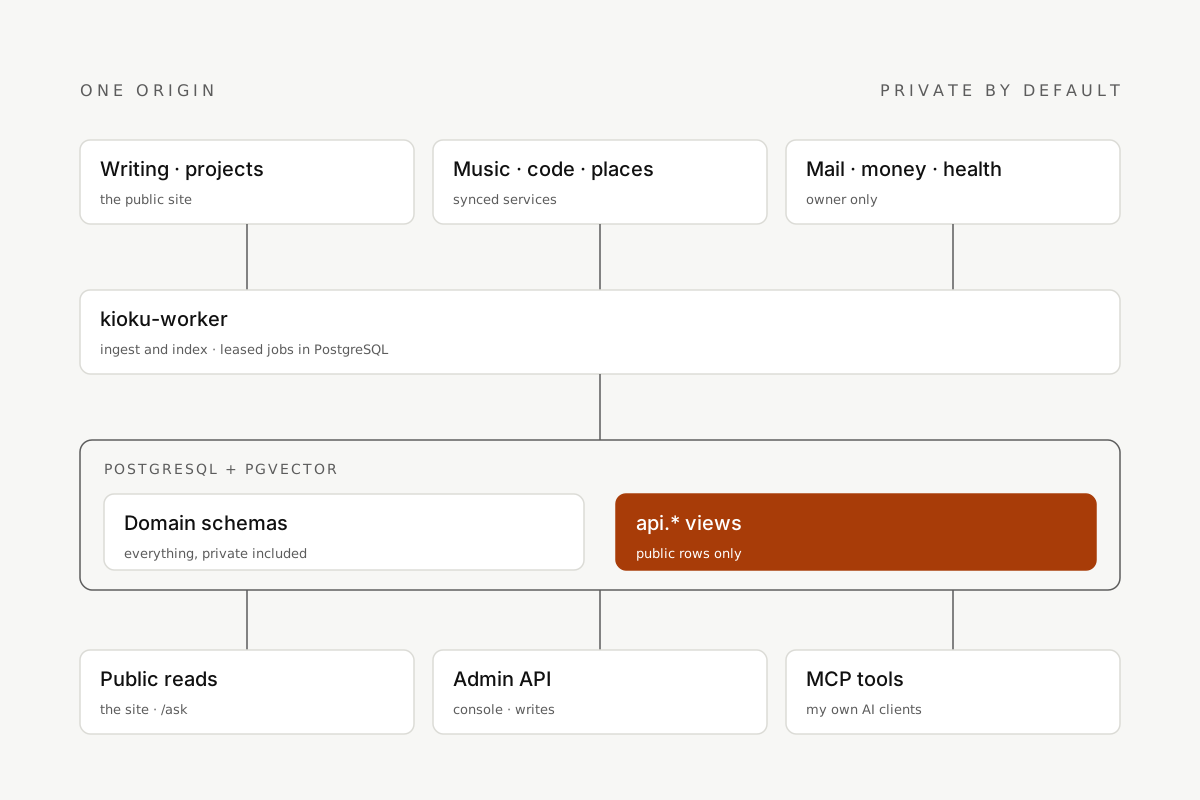
关于我的事实,只存一份, 入口有两个,谁也不借谁的权限。
我用的每个产品都留着一份「我」,每一份都在慢慢跑偏。Kioku 存放的是真正算数的那一份:一个 PostgreSQL,由定时任务和我自己的记录写入,其他一切都从它读取。访客在 /ask 提问、我自己的助手检索笔记,碰到的是同一份数据 —— 但访客那条路走的是一个看不见任何私有行的数据库角色,这一点由 PostgreSQL 决定,而不是靠提示词。
- 技术栈
- Python
- FastAPI
- PostgreSQL
- pgvector
- TypeScript
- MCP
- 分类
- Platform
为什么要做它
自己的上下文,自己拿着模型每隔几个月就进步一档,可每开一个新对话,我还是得先解释一遍我是谁。一个助手真正需要的事实 —— 我做过什么、写过什么、怎么工作 —— 散落在十几个产品里,每个产品都存着一份关于我的投影,又慢慢把这份投影当成了源头。把一段个人简介贴进提示词,也不过是又多一份拷贝。Kioku 起初只是这个网站背后的数据库,后来长成了这些事实真正归属的地方:工作经历、文章、照片、音乐、代码记录、去过的地方,还有永远不会公开的那几块 —— 邮件、财务、健康。它与其说是源头,不如说是镜像:大部分数据是从产生它们的服务里同步过来的。但现在只有一份了,其余的一切,包括这个网站,都从它派生。
整体结构
数据来源 → worker → 一个数据库 → 三个接口面worker 从产生数据的那些服务里拉取,靠 PostgreSQL 里的任务租约调度,进程崩了会被接手,而不是重跑一遍;iOS 伴侣应用从手机上推送,手机端有一个发件箱,服务器没应答就一直重发。所有数据最后落进同一个带 pgvector 的 PostgreSQL。它上面是一个 FastAPI 应用,分三个接口面 —— 公开读取、需要认证的管理 API、MCP 工具 —— 每个接口面通过各自的数据库角色读数据。Web 控制台和伴侣应用都是同一个 API 的客户端;控制台用的是和这个网站同一套设计系统。
边界在哪里
在对话之下强制执行让检索保持新鲜
增量索引 · 混合检索索引按内容哈希做差异比对,只重新嵌入变了的部分 —— 正因为这样,每天往里记东西才负担得起。可见性也算进哈希里,所以把一条笔记改成公开,哪怕一个字没动,也会重新同步;页面改了 slug,旧的身份会在新身份进索引之前先被删掉。全量重建依然存在,但它是修复手段,不是日常小改动进入检索的方式。检索本身分两半 —— 字面匹配负责确切的名字和短语,向量负责意思相近的内容 —— 再按排名融合,因为余弦相似度和文本命中根本不在一个量纲上。一套中英双语的标准用例,包括专门诱导泄露私人信息的问题,会拦在每一个 pull request 前面。
两个 AI 入口
共享数据,不共享权限公开的 /ask 回答关于我已发布作品的问题:它从公开视图里检索,跑一个最多三轮工具调用的有界 agent 循环,通过一个可以随时替换的网关调用模型,再把带引用的回答流式送回页面。公开证据不够时,它会直说不知道。私有的那条路是 MCP:我自己的 AI 客户端拿到的是一组工具 —— 检索全部内容、查询精确记录(数量和总额应该来自查询,而不是让模型从几段相似文字里估一个)、随手记一条笔记、给条目之间提议关联、启动后台任务。这个客户端替我做事,但它不是我。它有自己可撤销的凭证和数据库角色,每个工具都声明自己是读、是写还是启动任务,而且它不能发布、不能删除 —— 因为在这个凭证和数据之间,隔着一个刚刚可能读过某个网页的模型。
它在这个网站上做了什么
网站只是一个客户端这个网站上的每一个列表都是从 Kioku 的公开 API 读来的:项目、工作经历以及每段经历下的项目、摄影作品、博客、agent skills 目录。/ask 是从它那里流式返回的,联系表单也直接提交给它。网站只保留属于网站本身的那部分 —— 渲染和缓存、/ask 前面按访客计的突发限流、确认流量来自预期的边缘入口 —— 每日的费用上限则归 Kioku 管,因为真正给模型服务商付钱的是它。数据有变化时,Kioku 发出一个事件,只说明哪个集合变了;把它翻译成缓存标签是这个网站自己的决定,所以 Kioku 根本不知道网站缓存了什么。你正在读的这一页,背后也是 Kioku 里的一条项目记录。
决策与取舍
每一条都有带日期的决策记录从网站里拆出来,单独成一个仓库
Python 与 FastAPI,schema 归 Alembic 管
一个检索入口,而不是两个
关联只提议,不擅自写进图里
数据只能收紧权限,不能放宽权限
模型藏在网关后面,按用途命名
现在走到哪了
还只是镜像,不是源头真正做出来之后,我才看清问题到底在哪。存储从来不是难点,难的是源头。Kioku 里的大部分数据仍然产生在别人的系统里:平台一改导出接口,我这边就断;平台从来没记录过的东西,我这边也永远不会有。集中存储还会扩大一旦出事的波及面 —— 所以精力花在了最小权限、审计和备份上,而不是收集更多东西。语义索引仍然可能漏掉正确的段落,流式回答仍然可能中途失败;关键在于,这些风险每一个都有看得见的边界、有退路、有测试,而不是在前面贴一个「AI」标签了事。
想了解完整细节?
很乐意聊聊这个项目背后的架构、决策与取舍。
更多作品
EFFICIENT 系统
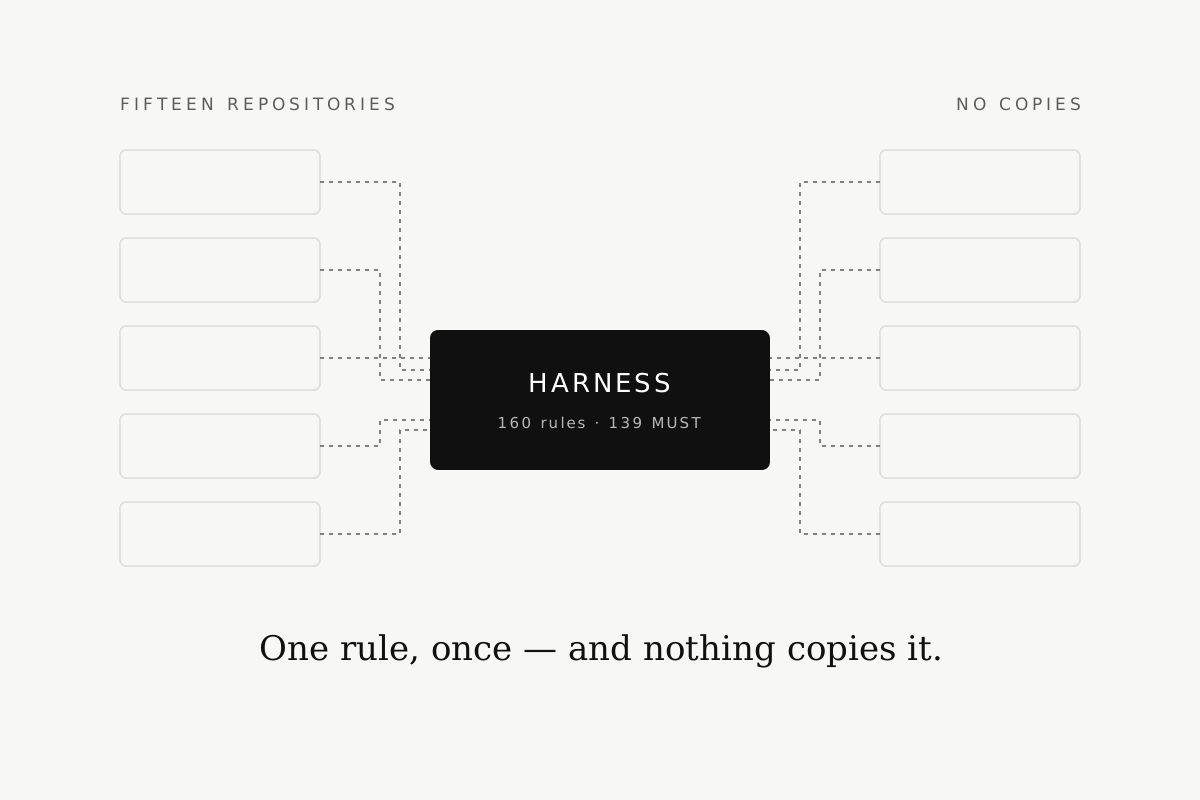
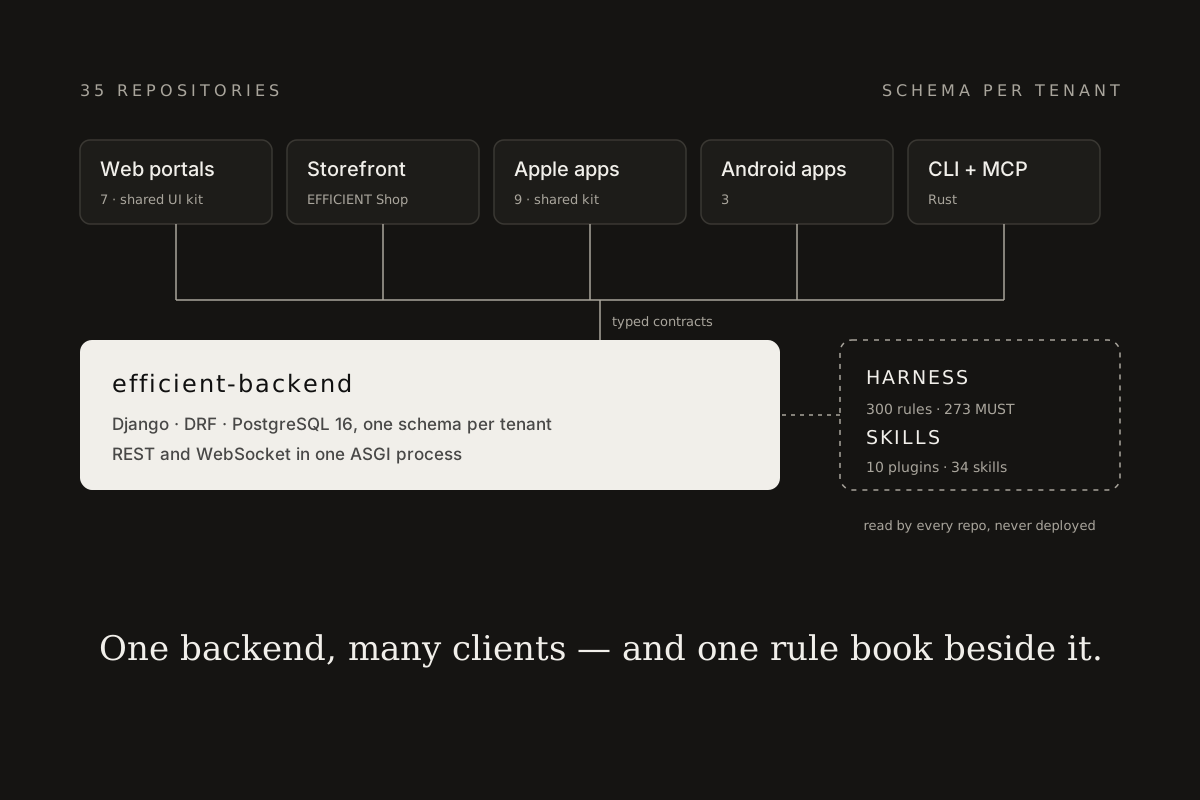
一套多租户的轮毂轮胎 ERP 与电商平台 —— 一个 Django 后端、一套共享 React UI kit、七个 Web 门户、一个店面、九个 Apple App 和三个 Android App,以及一个带 MCP server 的 Rust CLI。我负责的是它们下面那一层:一份共享工程契约,以及让各仓库遵循这份契约的 agent 工作流。
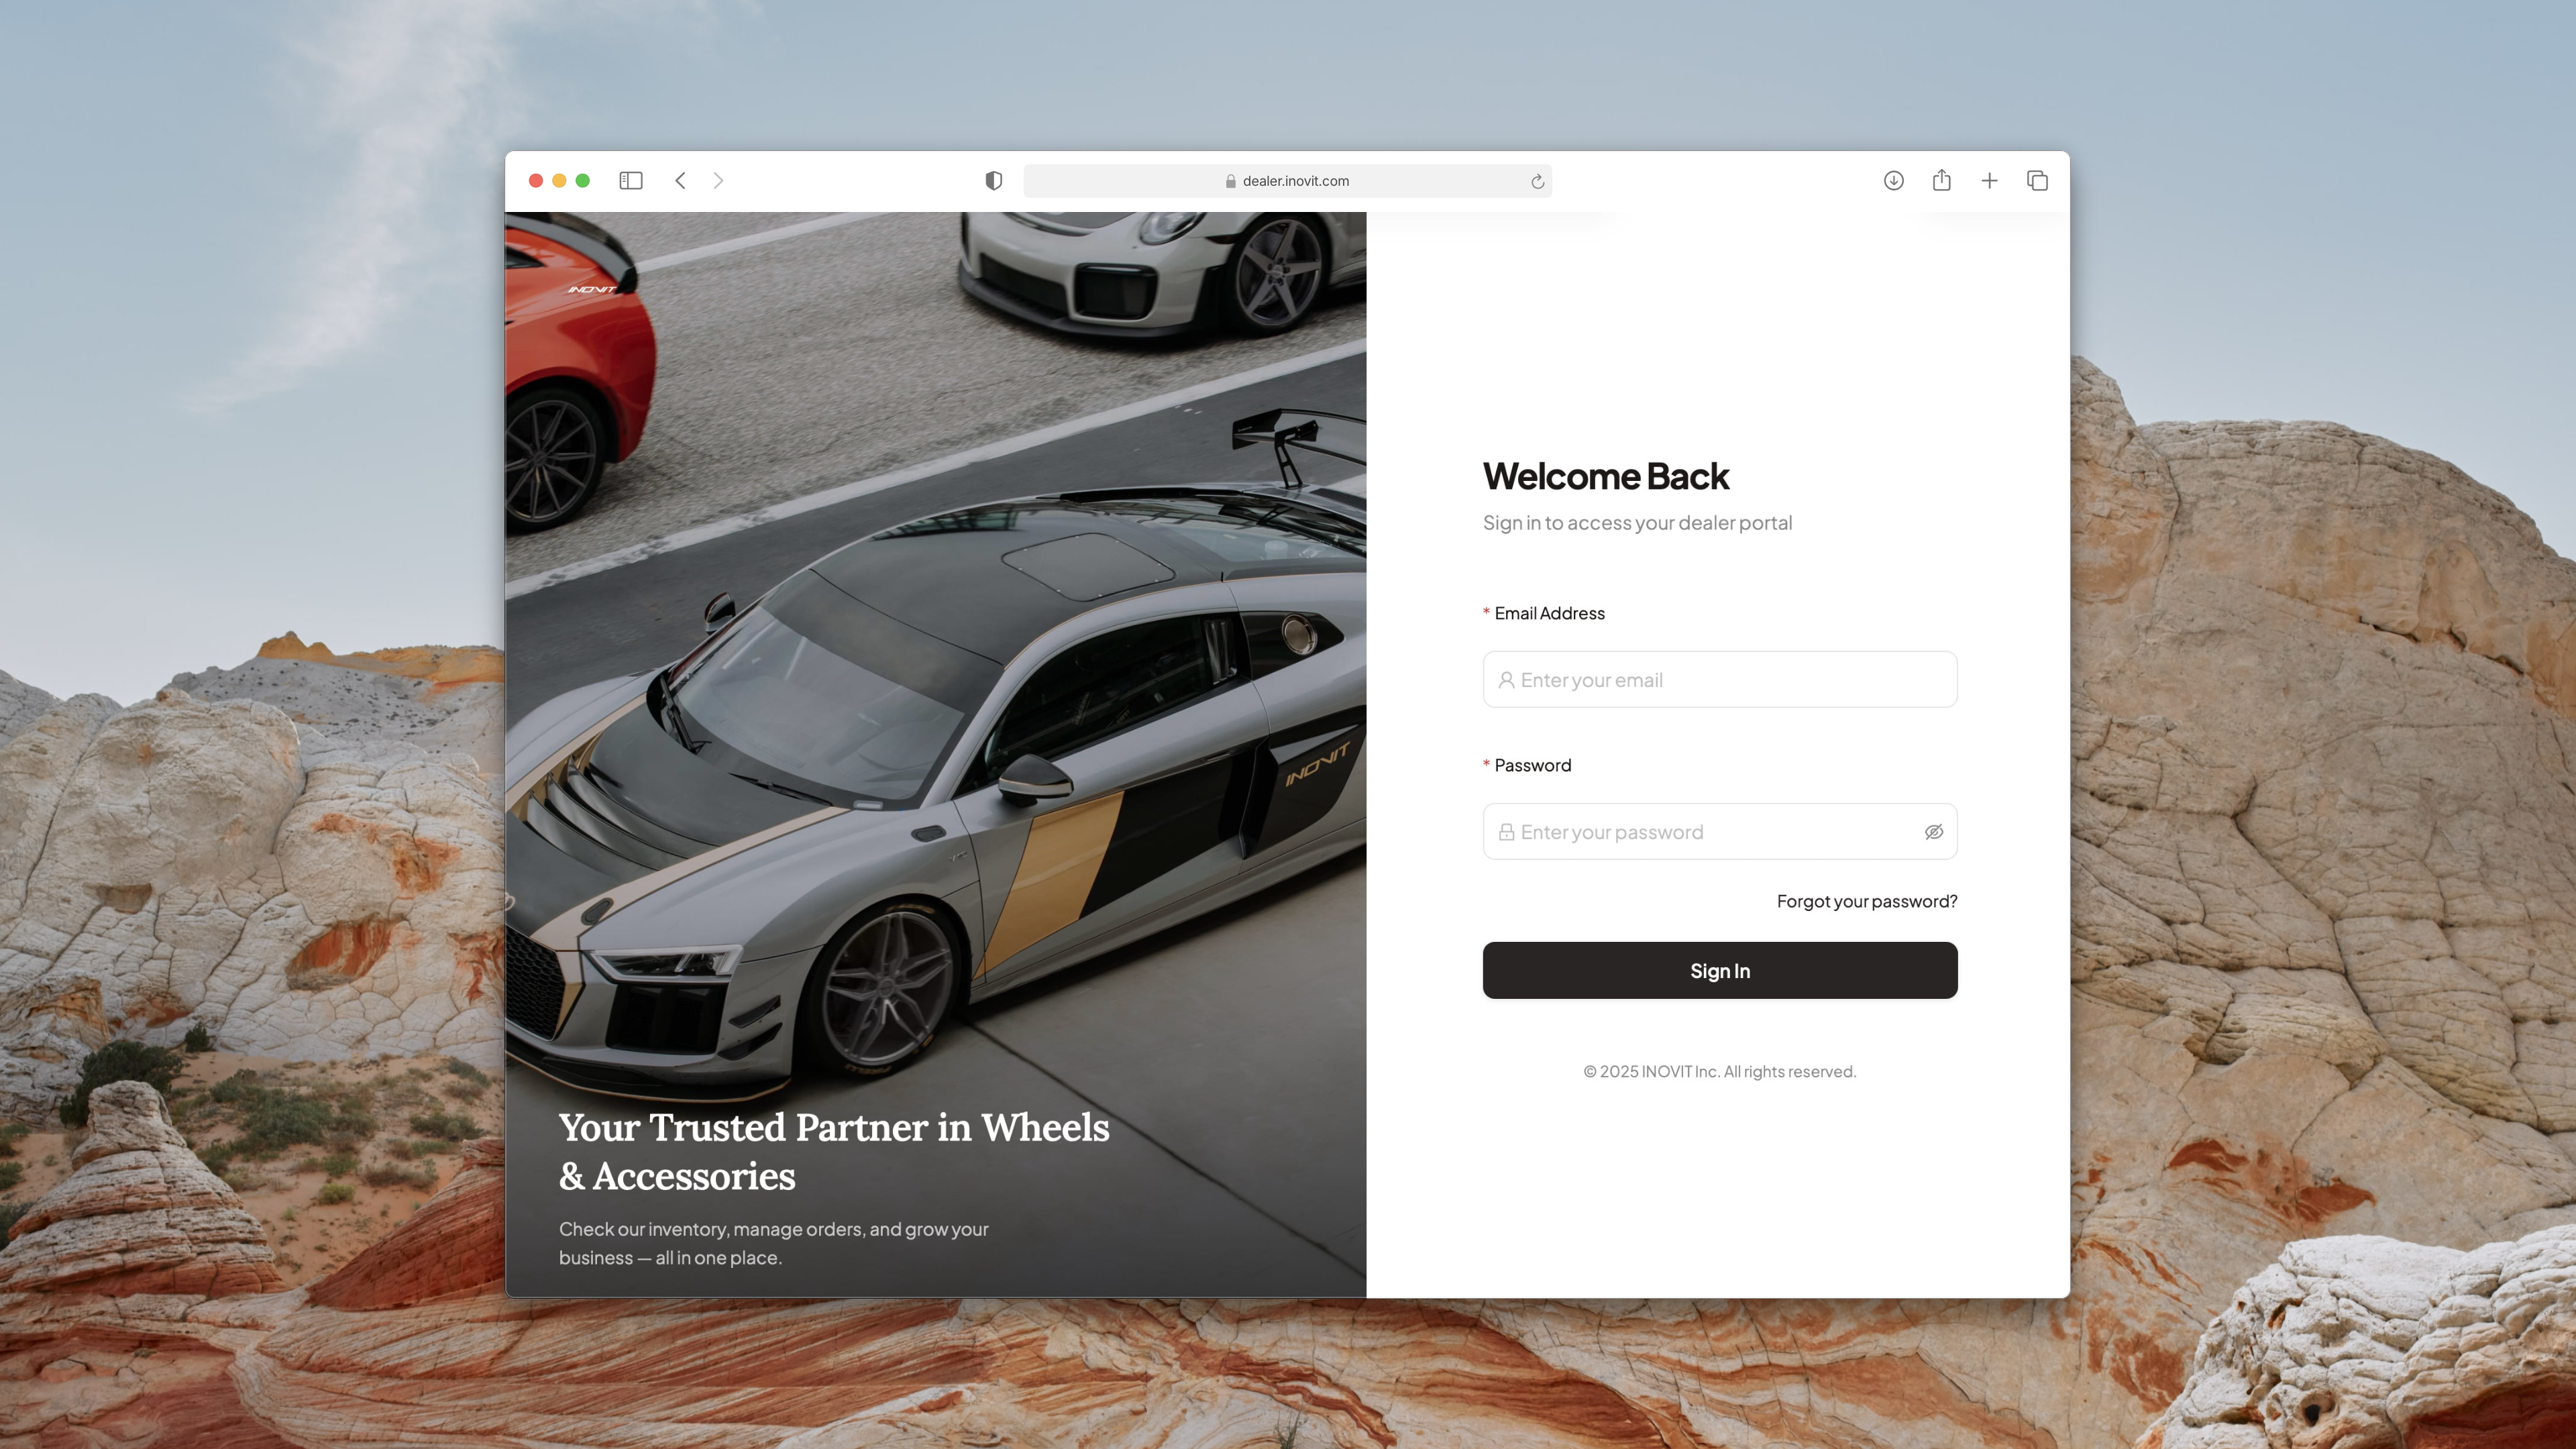
INOVIT 经销商门户


B2B 电商平台,替换遗留 .NET ERP —— 49 个 API 端点、4 区域数据库路由、跨仓库 OpenAPI 类型生成、共享生产 SQL Server 上的零停机迁移。
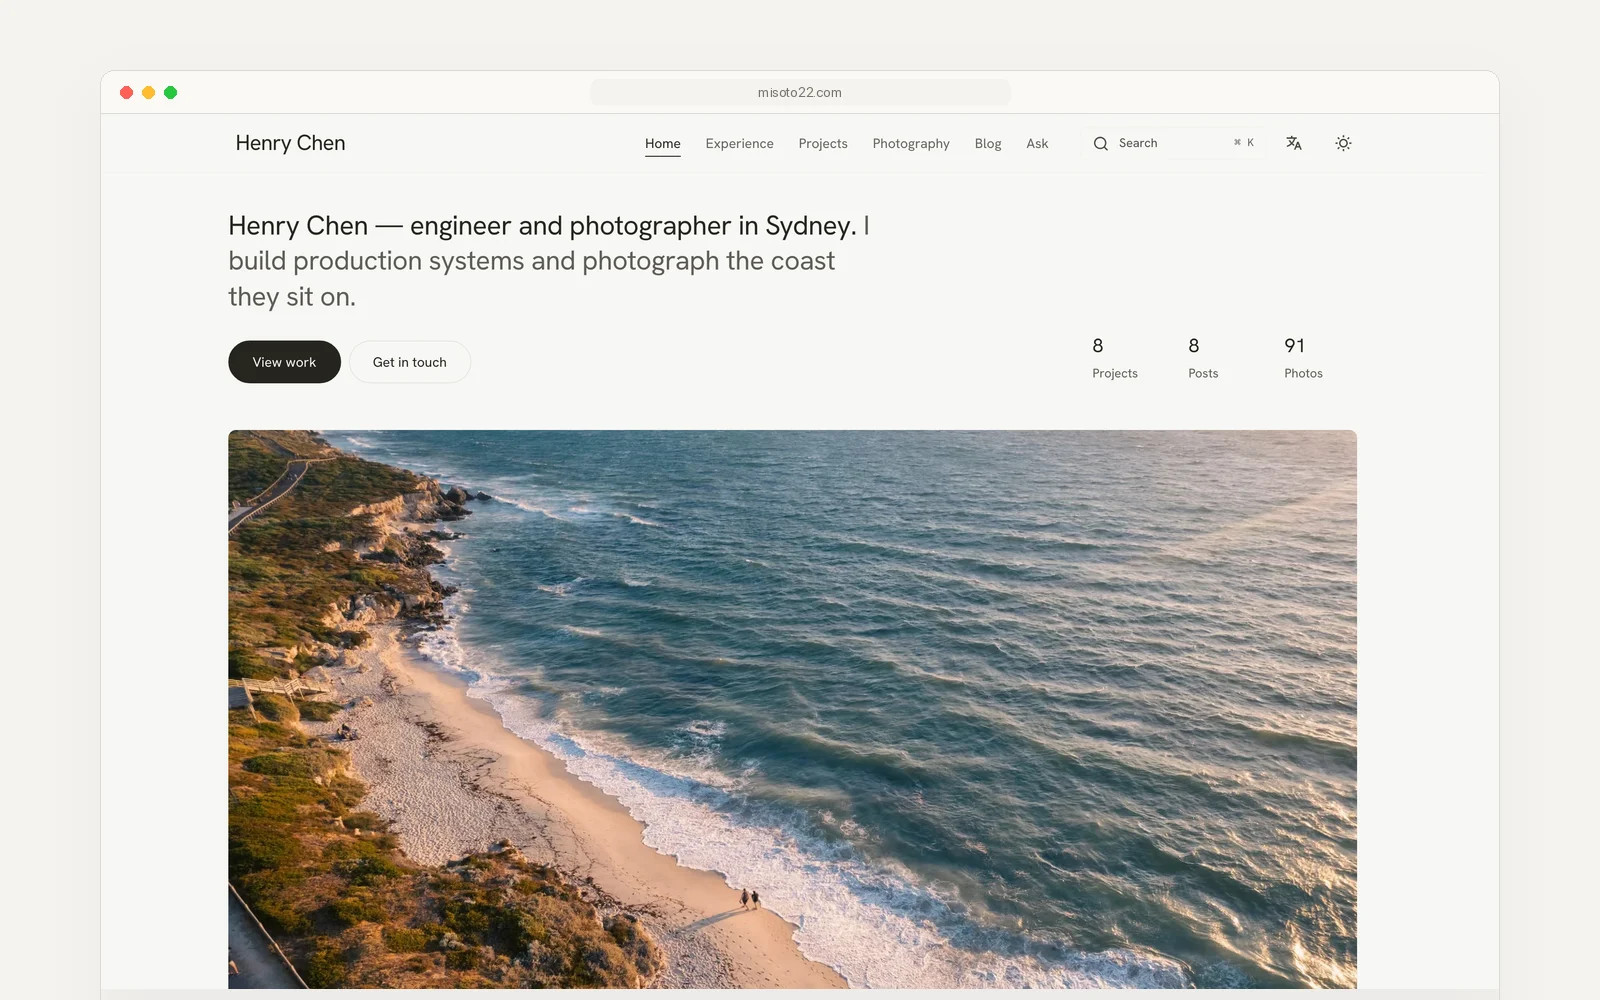
个人网站


双语作品集网站,包含基于站点自身内容的 AI 助手、隐私优先的分析、博客、摄影画廊与符合 WCAG AAA 的颜色对比度 —— 自托管 Docker 部署,独立开发。